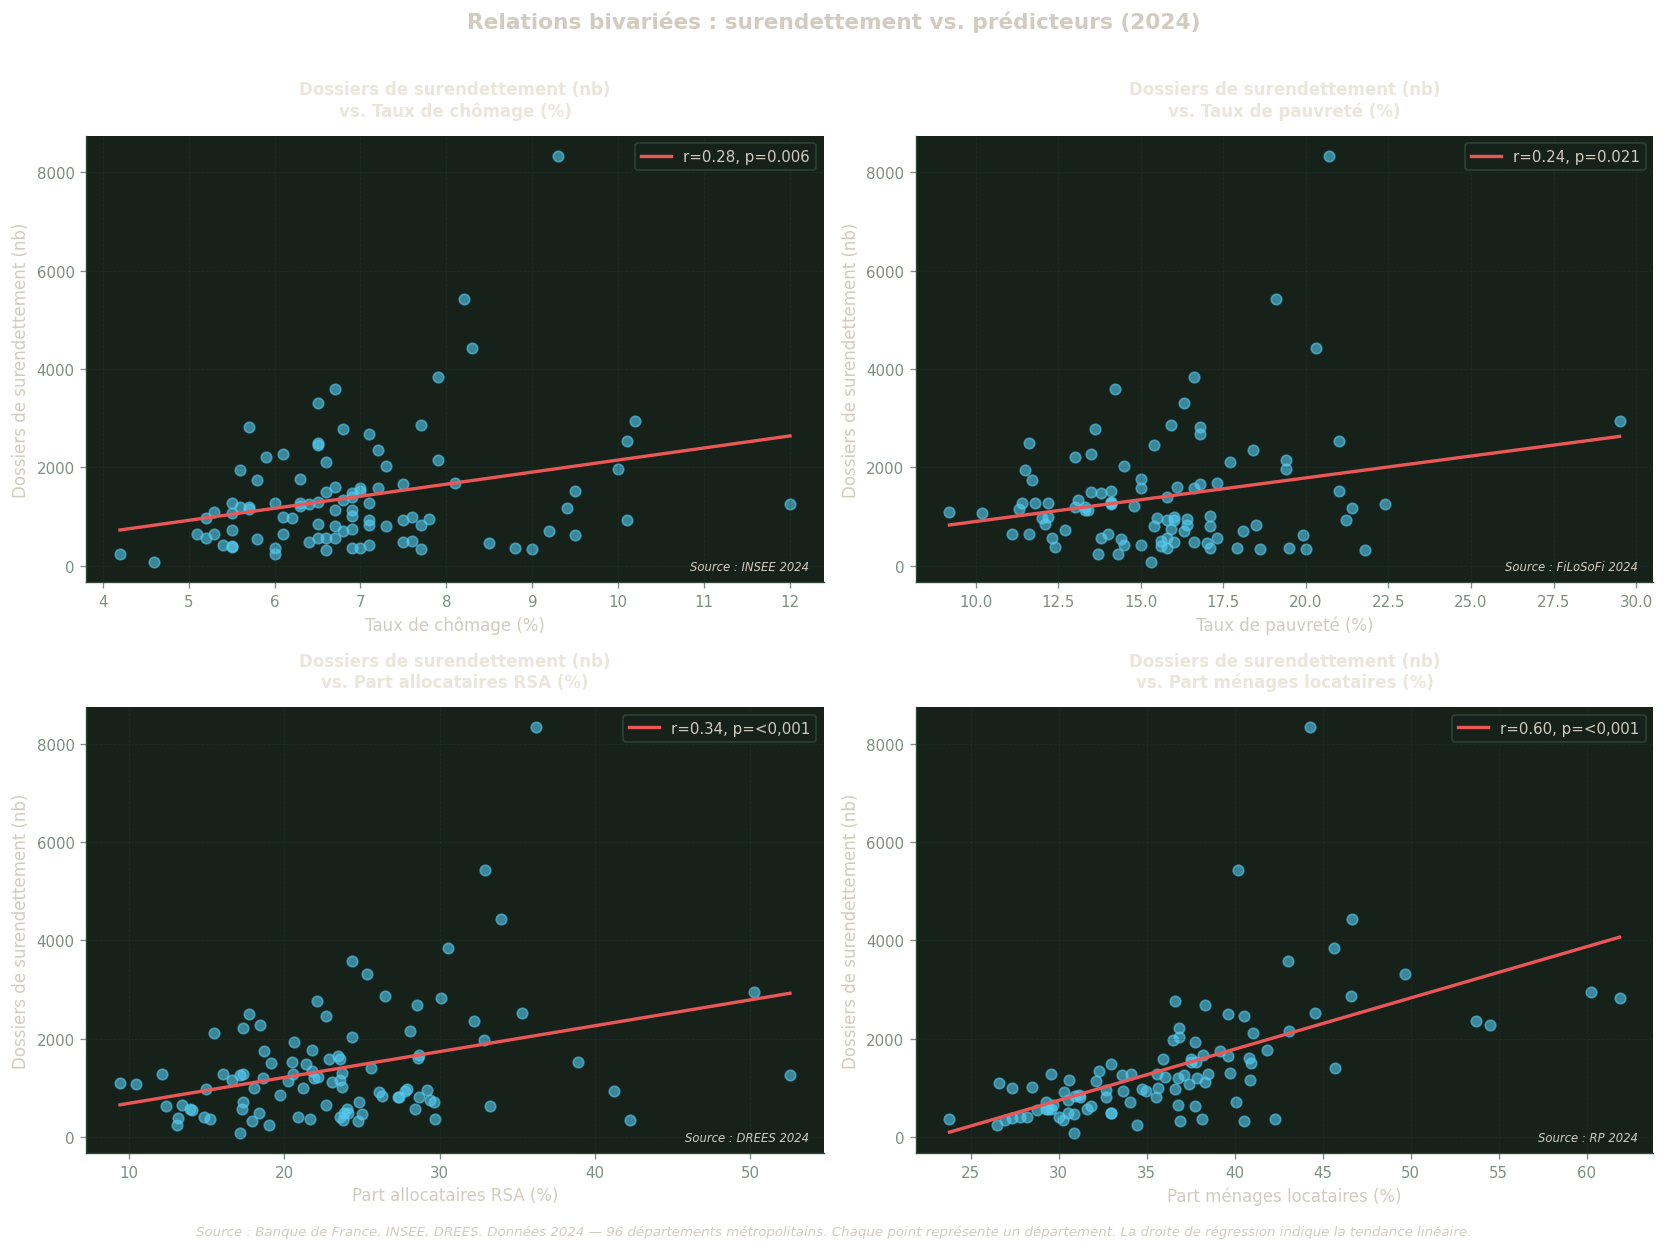
if EDA_AVAILABLE:
    scatter_vars = [
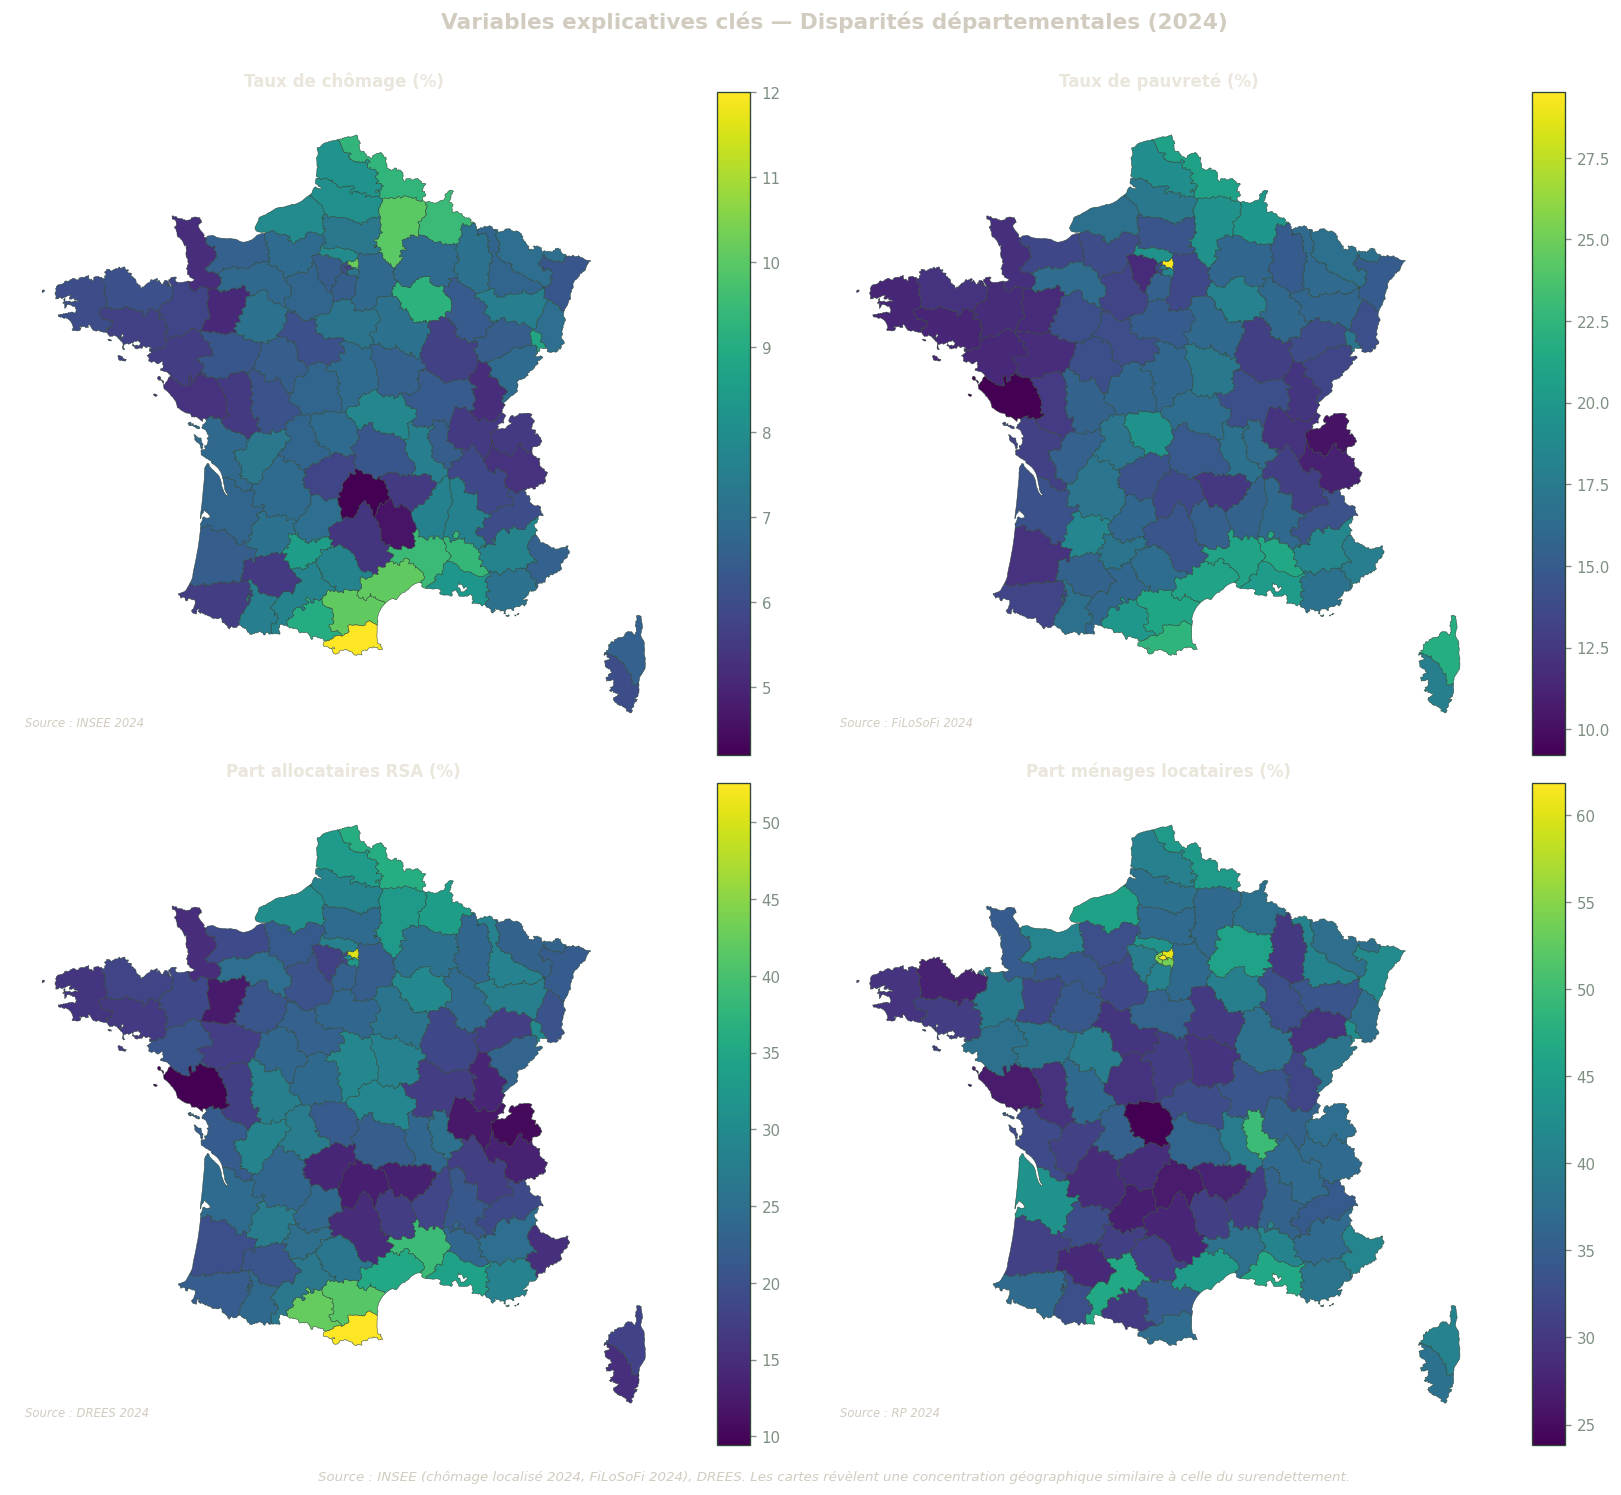
        ("chomage_taux",      "Taux de chômage (%)",            f"INSEE {YEAR_TARGET}"),
        ("taux_pauvrete",     "Taux de pauvreté (%)",           f"FiLoSoFi {YEAR_FILOSOFI}"),
        ("rsa_taux",          "Part allocataires RSA (%)",      f"DREES {YEAR_TARGET}"),
        ("part_locataires",   "Part ménages locataires (%)",    f"RP {YEAR_TARGET}"),
    ]
    y_col_scatter = "suren_depot_nb"
    y_label = "Dossiers de surendettement (nb)"

    available_scatter = [
        (col, label, src) for col, label, src in scatter_vars
        if col in df_2021.columns
        and pd.to_numeric(df_2021[col], errors="coerce").notna().sum() >= 20
    ]

    if available_scatter:
        from scipy import stats as scipy_stats

        n_cols = min(2, len(available_scatter))
        n_rows = (len(available_scatter) + n_cols - 1) // n_cols
        fig, axes = plt.subplots(n_rows, n_cols, figsize=(14, 5 * n_rows))
        if len(available_scatter) == 1:
            axes = [[axes]]
        elif n_rows == 1:
            axes = [axes]

        for idx, (col, label, src) in enumerate(available_scatter):
            row, col_idx = divmod(idx, n_cols)
            ax = axes[row][col_idx] if n_rows > 1 else axes[0][col_idx]

            x_data = pd.to_numeric(df_2021[col], errors="coerce")
            y_data = pd.to_numeric(df_2021[y_col_scatter], errors="coerce")
            valid  = pd.DataFrame({"x": x_data, "y": y_data}).dropna()

            ax.scatter(valid["x"], valid["y"], color=_CYAN, alpha=0.6, s=40)

            if len(valid) >= 5:
                slope, intercept, r_val, p_val, _ = scipy_stats.linregress(valid["x"], valid["y"])
                x_line = np.linspace(valid["x"].min(), valid["x"].max(), 100)
                ax.plot(x_line, intercept + slope * x_line, color=_RED, linewidth=2,
                        label=f"r={r_val:.2f}, p={'<0,001' if p_val < 0.001 else f'{p_val:.3f}'}")
                ax.legend(fontsize=9)

            ax.set_xlabel(label, fontsize=10)
            ax.set_ylabel(y_label, fontsize=10)
            ax.set_title(f"{y_label}\nvs. {label}", fontsize=10, fontweight="bold")
            ax.grid(alpha=0.3)
            ax.text(
                0.98, 0.02, f"Source : {src}",
                transform=ax.transAxes, fontsize=7, style="italic", va="bottom", ha="right",
            )

        for idx in range(len(available_scatter), n_rows * n_cols):
            row, col_idx = divmod(idx, n_cols)
            if n_rows > 1:
                axes[row][col_idx].set_visible(False)
            else:
                axes[0][col_idx].set_visible(False)

        fig.suptitle(
            f"Relations bivariées : surendettement vs. prédicteurs ({YEAR_TARGET})",
            fontsize=13, fontweight="bold", y=1.01,
        )
        fig.text(
            0.5, -0.01,
            f"Source : Banque de France, INSEE, DREES. Données {YEAR_TARGET} — 96 départements métropolitains. "
            "Chaque point représente un département. La droite de régression indique la tendance linéaire.",
            ha="center", fontsize=8, style="italic", wrap=True,
        )
        plt.tight_layout()
        plt.show()
    else:
        print(
            "⚠️ Graphiques bivariés limités aux variables disponibles.\n"
            "Variables FiLoSoFi, RP, minimas sociaux indisponibles — "
            "seul le chômage peut être représenté une fois les données téléchargées."
        )
        # Scatter chômage seul si disponible
        x_data = pd.to_numeric(df_2021["chomage_taux"], errors="coerce")
        y_data = pd.to_numeric(df_2021["suren_depot_nb"], errors="coerce")
        valid  = pd.DataFrame({"x": x_data, "y": y_data}).dropna()
        if len(valid) >= 20:
            from scipy import stats as scipy_stats
            fig, ax = plt.subplots(figsize=(8, 5))
            ax.scatter(valid["x"], valid["y"], color=_CYAN, alpha=0.6, s=40)
            slope, intercept, r_val, p_val, _ = scipy_stats.linregress(valid["x"], valid["y"])
            x_line = np.linspace(valid["x"].min(), valid["x"].max(), 100)
            ax.plot(x_line, intercept + slope * x_line, color=_RED, linewidth=2,
                    label=f"r={r_val:.2f}, p={'<0,001' if p_val < 0.001 else f'{p_val:.3f}'}")
            ax.legend(fontsize=9)
            ax.set_xlabel("Taux de chômage (%)", fontsize=10)
            ax.set_ylabel("Dossiers de surendettement (nb)", fontsize=10)
            ax.set_title(f"Surendettement vs. Chômage ({YEAR_TARGET})", fontsize=11, fontweight="bold")
            ax.grid(alpha=0.3)
            fig.text(
                0.5, -0.04,
                f"Source : Banque de France (surendettement), INSEE chômage localisé (chômage). {YEAR_TARGET} — 96 départements.",
                ha="center", fontsize=8, style="italic"
            )
            plt.tight_layout()
            plt.show()
else:
    print("⚠️ Données EDA non disponibles — exécuter les scripts 01-04 d'abord.")